

龙舌兰酒是一种传统的墨西哥烈酒,在全球消费量排名第四,每年销量超过2亿升。因此,质量控制对于了解、表征和监测其陈酿过程、酒精含量以及决定各类龙舌兰酒风味、颜色和独特香气的挥发性成分来说,变得越来越重要。本文开发的分析系统包括一个图像采集平台,可直接从龙舌兰酒样品中捕获并数字化图像,以及一个基于色觉三色理论的仿生处理阶段,在此背景下对图像的RGB吸光度进行评估,随后使用主成分分析(PCA)和线性判别分析(LDA)进行区分,从而能够正确分类来自哈利斯科州地区的三种主要龙舌兰酒类别。
01 RGB图像分析
通过电子眼的实验阶段,共捕获了750张龙舌兰酒图像(25个样品,每个样品重复3次,每次拍摄10张照片)。图1展示了4个代表性样本及其对应的捕获图像,包括每类龙舌兰酒各1个样品以及空白溶液。紫外比色皿图像内的黑色虚线标记了所选的ROI区域。
直方图可视化结果显示,图像中存在与对应RGB通道相关的红、绿、蓝像素。可以看出,不同类型龙舌兰酒的颜色通道分布及其强度存在明显差异。同理,在固定相机参数(曝光时间、光圈、感光度)和相同光照条件下,图像中捕获的信息具有代表性,可用于构建分类器模型以识别不同类别的龙舌兰酒。
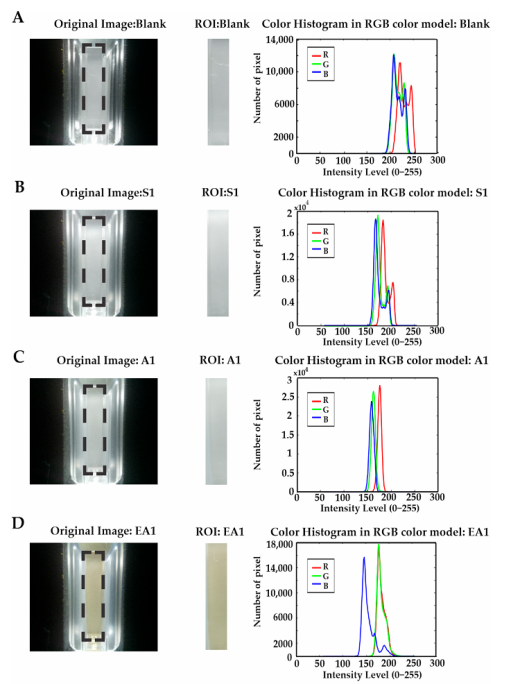
图1(A)空白溶液、(B)银色龙舌兰酒、(C)陈酿龙舌兰酒、(D)特级陈酿龙舌兰酒样品的代表性图像。从左到右依次标注了电子眼(EE)捕获的图像、感兴趣区域(ROI),以及红、绿、蓝(RGB)强度直方图
作为参考,颜色已成为食品质量测量的重要因素之一。为此,可使用RGB模型,因为它是检测数字图像颜色变化的最佳模型之一。通过这种方式,采集的图像被组织为30×75的矩阵:行对应总重复次数(3次测试,每次测试重复10次),列代表25个龙舌兰酒样品的三次重复分析结果。表1总结了RGB通道的强度、各RGB通道吸光度及样品总吸光度。可以建立电子眼提供的每张图像的吸光度与样品成分之间的关联。根据RGB模型,图像的吸光度是基于各颜色通道的平均值计算的。如表1所示,从不同龙舌兰酒样品的图像中,得到了每个颜色强度通道的平均值、标准差,以及对应的吸光度。
表1 龙舌兰酒样品的电子眼RGB三通道光强与吸光度数值,同时列出总吸光度数据
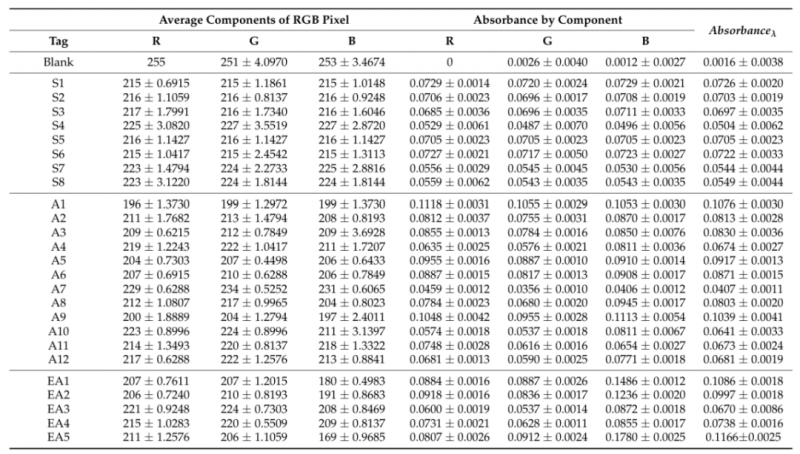
银色龙舌兰酒样品的吸光度为0.0644±0.0034,而陈酿和特级陈酿龙舌兰酒样品的平均吸光度分别为0.0785±0.0024和0.0931±0.0019。样品中呈现的变异性可归因于各品牌产品的特性,以及它们独特的陈酿过程。因此,银色龙舌兰酒的最低吸光度与其无色、纯净的色调相关。
在RGB通道的强度方面,银色龙舌兰酒样品的三个通道强度分布较为均衡。而陈酿龙舌兰酒样品以红色和蓝色通道为主,特级陈酿龙舌兰酒样品中蓝色通道的占比更高、强度也最大。这些差异与样品呈现的色调相关——即便属于同一类龙舌兰酒,这些色调差异也会因品牌不同而变化。
为了可视化不同龙舌兰酒样品的RGB吸光度变化规律,研究构建了雷达图。图2展示了按三类分组的所有龙舌兰酒的RGB平均吸光度,从中可观察到每种龙舌兰酒与其光学特性相关的特征“指纹”。每类龙舌兰酒(银色、陈酿、特级陈酿)呈现出的明显模式,将有助于后续分类器模型对这些信息的解读。模式识别过程的核心逻辑,是通过搭载机器学习算法的计算模型,识别数据中存在的规律。
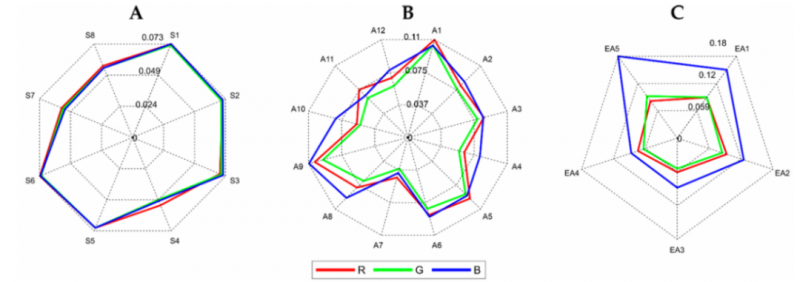
图2 分析的龙舌兰酒样品及其对应吸光度值的雷达图。(A)银色、(B)陈酿、(C)特级陈酿
02 电子眼初步识别模型
建模前,先将RGB平均吸光度归一化到0-1区间,以降低光照影响并便于数据处理。随后通过主成分分析(PCA)构建初步识别模型,期望观察到由吸光度和龙舌兰酒类别引发的样品聚类。包含三个主要主成分的PCA图如图3所示,其累计解释方差约为99.96%,并形成了可部分区分不同龙舌兰酒的特征聚类:大多数银色龙舌兰酒集中在图的右上区域,陈酿龙舌兰酒聚集在中心,特级陈酿龙舌兰酒则分布在左侧区域。不过,后两类龙舌兰酒的聚类存在明显离散性,部分样品还出现了重叠。
从这个角度看,PCA中观察到的聚类区域是合理的——样品被归到了对应的类别中,且每个聚类与不同的陈酿周期相关。因此,陈酿和特级陈酿龙舌兰酒聚类中的离散性,显然与各生产商为其产品规定的陈酿时间有关;而银色龙舌兰酒聚类的离散性极小,因为这类样品并无陈酿过程。
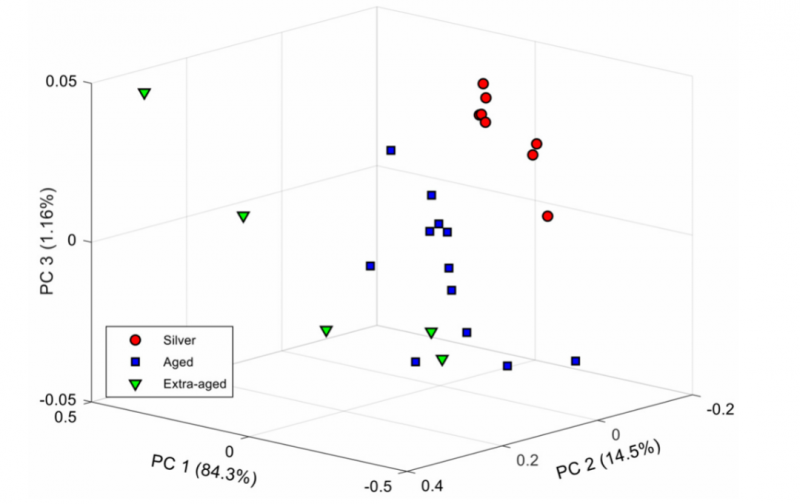
图3 龙舌兰酒样品分析后得到的前三个主成分的PCA得分图
因此,在分析的龙舌兰酒样品集中,即便属于同一类别,也很可能存在陈酿时间不同的产品。这是因为每个龙舌兰酒生产商必须遵守墨西哥法规,满足最低陈酿时间要求;但他们也可以在不违反标准规定的前提下,延长陈酿周期,以提供感官特性优于竞品的产品。基于此,为了验证PCA中观察到的初步识别结果,下一步采用了LDA这一有监督模式识别方法。
03 龙舌兰酒类别的区分
将PCA得到的变换后数据作为输入,进行LDA分析。由于这是有监督方法,分类效果通过留一法交叉验证(LOOCV)评估:在该方案中,每个样品的分类依据是由其余样品(排除自身)推导的分析函数;此过程重复次数与数据集中的样品数一致(即25次),每次排除一个不同的样品作为验证样本,确保所有样品都被用作一次验证。如图4所示,三类龙舌兰酒实现了清晰的区分。图中的聚类表明,龙舌兰酒样品根据其对应的陈酿过程完成了分组:银色龙舌兰酒明显聚集在图的左侧区域,而陈酿和特级陈酿龙舌兰酒的类中心则分别位于中间和右侧区域。
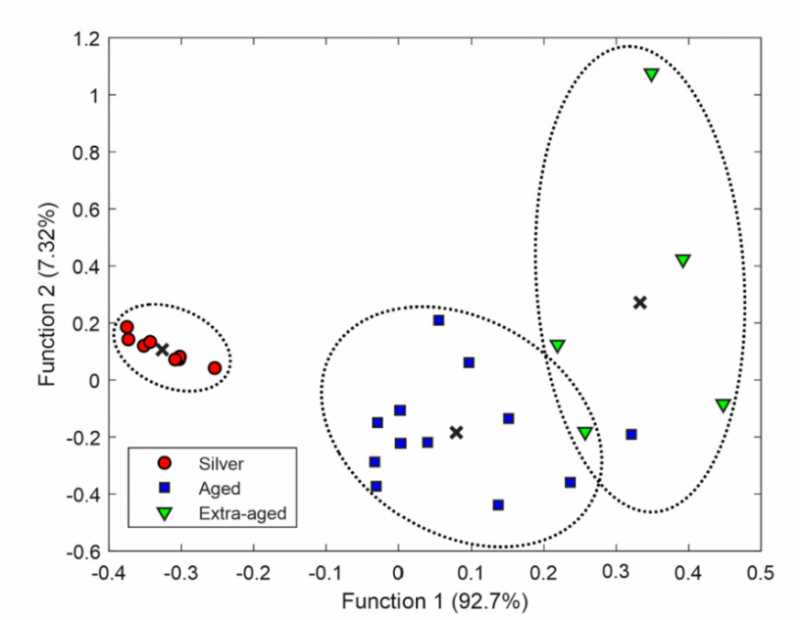
图4 龙舌兰酒样品分析后得到的函数对应的LDA得分图(按类别划分)虚线代表分类聚类,同时还标注了每类的中心(用“x”表示)
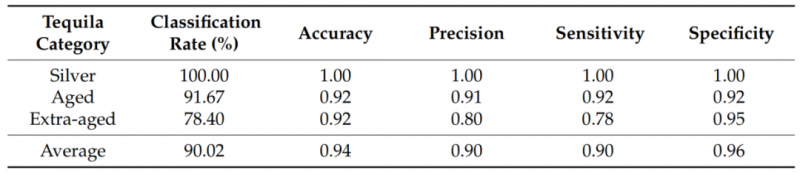
表2报告了25个LDA模型的平均分类结果。正如LDA图所预期的,银色和陈酿龙舌兰酒样品实现了正确分类,分类率较高(分别为100%和91.67%);相比之下,特级陈酿类别的正确分类率未超过78.40%。三类样品的总体分类率为90.02%。为评估建模效率,研究还计算了准确率、精确率、灵敏度和特异度:三类样品的平均灵敏度为0.90,特异度为0.96。
表2 PCA-LDA模型分类效果
许多研究已证实,当各类别样品数量不均衡时,总体分类率并非衡量分类器性能的最佳标准。在本研究结果中,尽管LDA建模的结果具有显著性,但仍需采用另一项指标,以更明确地反映这种不均衡情况下分类器的性能。科恩kappa系数是准确率的一种常用替代衡量指标,其核心计算逻辑是分析参考数据与由混淆矩阵主对角线确定的输入数据之间的差异(定义见式(3)):
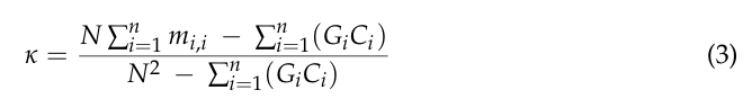
其中,i为类别编号,N是与真实值对比的分类值总数,m i,i是真实类别为i且被分类为类别i的值数量(即混淆矩阵主对角线上的值),Ci是类别i的预测值总数,Gi是类别i的真实值总数。kappa系数的取值范围为0到1:0代表完全不一致,1代表完全一致。根据其判定标准,k<0表示无一致性,0-0.20为轻微一致,0.21-0.40为尚可一致,0.41-0.60为中等一致,0.61-0.80为显著一致,0.81-1为几乎完全一致。
本研究中,基于留一法交叉验证过程计算了25个LDA模型的kappa值,得到的总体平均kappa系数为0.87,属于“几乎完全一致”的水平。这一结果表明,用于识别龙舌兰酒样品的RGB吸光度具有足够的代表性,可用于建模;同时,尽管龙舌兰酒类别存在不均衡,但LDA模型并未偏向样品数量最多的陈酿类,也未轻视样品数量最少的特级陈酿类。
此外,从结果中还可确认,即便使用留一法交叉验证,也未使LDA分类器的性能评估出现过度乐观的情况。


